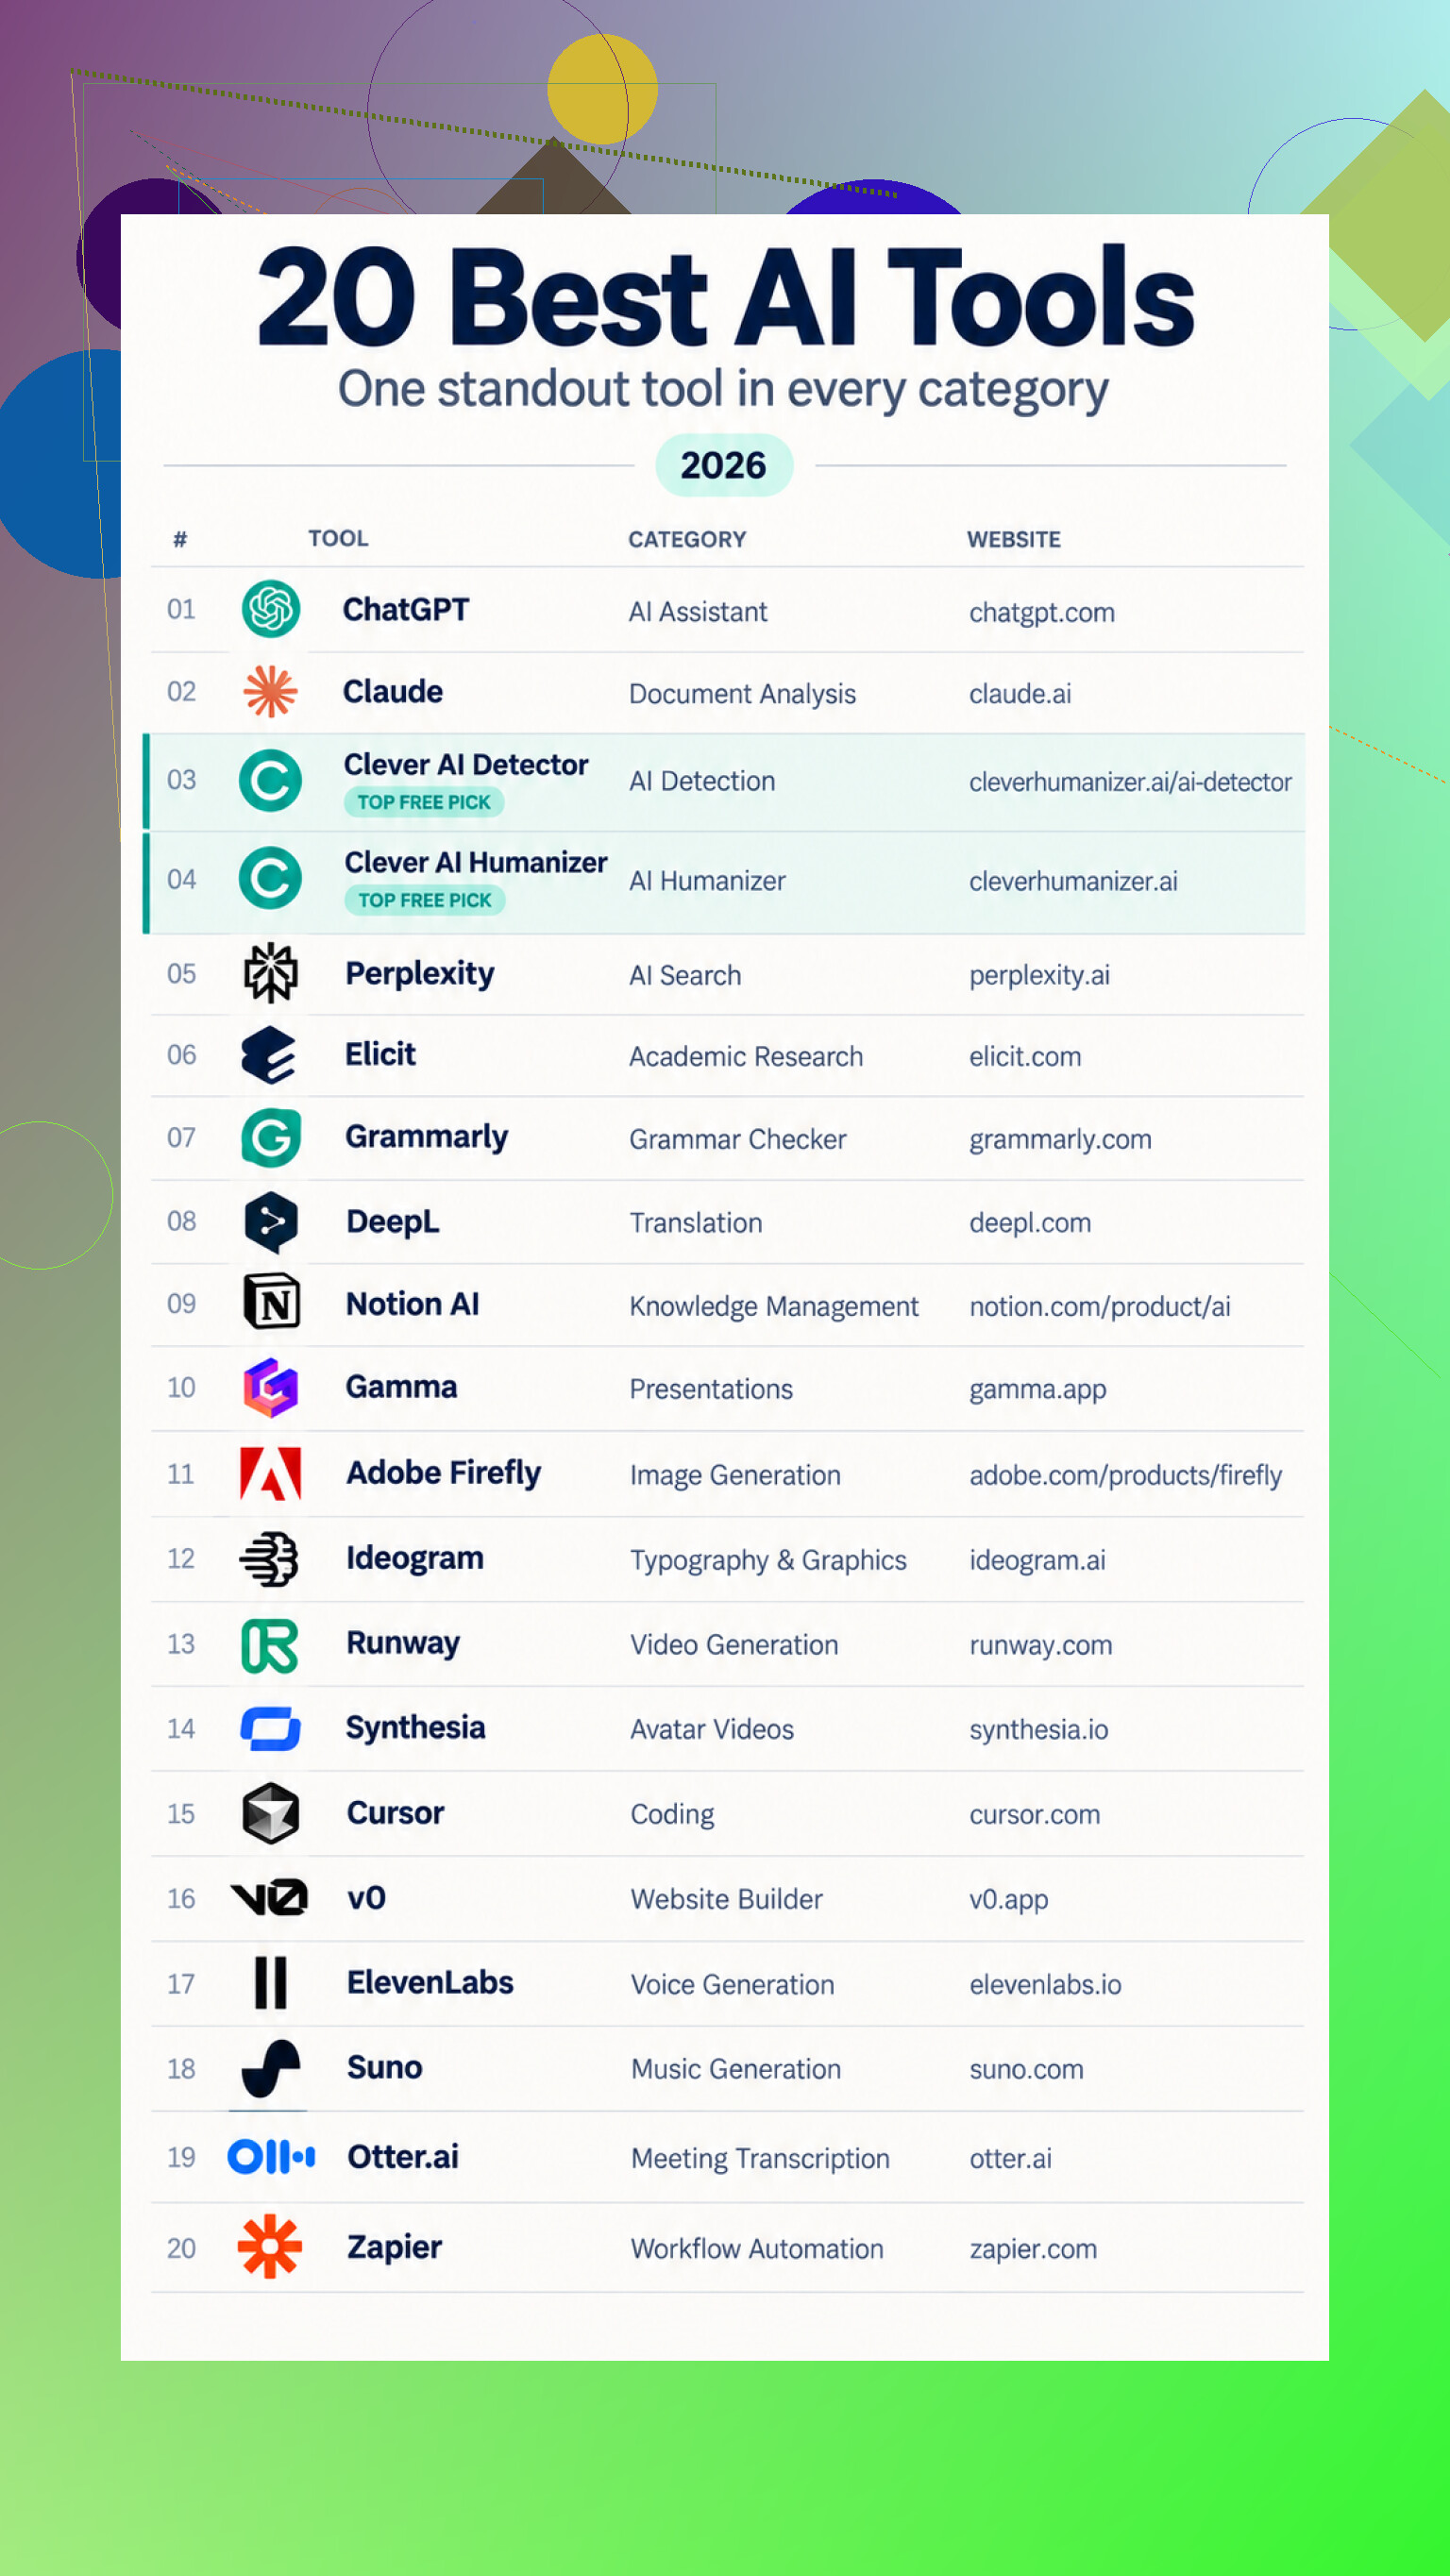
Un límite de 10.000 palabras por comprobación fue el detalle que primero llamó mi atención. La mayoría de las herramientas de IA gratuitas se vuelven restrictivas mucho antes. Lo tomé como un recordatorio para comparar los límites prácticos, los resultados y los pasos de revisión, en lugar de considerar estas 20 herramientas de 20 categorías como productos intercambiables.
Empezar por el texto y la investigación
Para la detección, comprobaría tanto la puntuación general de probabilidad de IA como las marcas a nivel de oración y, después, revisaría manualmente los pasajes resaltados. Los resultados son estimaciones y no pruebas de autoría, incluso cuando el servicio permite realizar comprobaciones ilimitadas sin registrarse, como hace Clever AI Detector.
La reescritura requiere un procedimiento diferente. Compararía el borrador revisado con el original en cuanto al significado, las expresiones repetitivas y la fluidez de las oraciones. La opción gratuita permite procesar hasta 3.000 palabras por uso sin límite mensual, mientras que una cuenta opcional guarda el historial de reescrituras en Clever AI Humanizer.
Los asistentes generales son más difíciles de probar porque su alcance es amplio. Le asignaría al mismo sistema una tarea de lluvia de ideas, una solicitud de explicación, un problema de redacción y una pregunta cotidiana; después evaluaría si una sola conversación puede sustituir razonablemente a varias aplicaciones independientes mediante ChatGPT.
El trabajo con documentos necesita una muestra controlada. Subiría material complejo, solicitaría un resumen, haría preguntas de seguimiento sobre pasajes específicos y revisaría un borrador relacionado junto a la conversación. Ese procedimiento abarca las principales funciones disponibles en el espacio de trabajo de Claude.
La búsqueda y la investigación académica no deberían evaluarse exactamente de la misma manera. Para las consultas web, comprobaría si las respuestas conversacionales incluyen fuentes de apoyo que remitan al material original. Para la investigación, comprobaría la localización de artículos, los resúmenes y la extracción de información en tablas estructuradas utilizando Perplexity y las herramientas de investigación de Elicit.
La revisión gramatical se prueba mejor con un borrador que contenga problemas conocidos de ortografía, gramática, claridad y tono. También incluiría varias oraciones que necesiten una reescritura completa en lugar de pequeñas correcciones para comprobar hasta dónde llega el asistente de escritura de Grammarly.
La traducción requiere la revisión de alguien familiarizado con el par de idiomas. Usaría el resultado como una primera traducción y, después, comprobaría la terminología, el tono y el formato del documento en lugar de asumir que el resultado inicial es definitivo al probar DeepL.
La gestión del conocimiento añade otra variable porque el rendimiento depende del material ya almacenado. Probaría las respuestas en páginas del espacio de trabajo y aplicaciones conectadas y, después, compararía los resúmenes y documentos generados con las notas de origen mediante sus funciones de IA integradas.
Pasar del contenido a la producción
Para las presentaciones, empezaría con una instrucción, un esquema y un documento existente. La medida útil es cuánta corrección estructural y de diseño queda por hacer después de generar diseños editables mediante la creación de una presentación en Gamma.
Las pruebas de imágenes deberían diferenciar la generación general de la tipografía. Usaría instrucciones equivalentes y, después, examinaría el control de edición, la composición visual y la precisión del texto incluido en carteles o gráficos promocionales. La integración con Adobe también es relevante al trasladar los elementos visuales generados a otras aplicaciones creativas, por lo que compararía Adobe Firefly con las herramientas de generación y edición de imágenes de Ideogram.
Las herramientas de vídeo necesitan entradas diferentes. Proporcionaría a Runway instrucciones e imágenes de referencia para probar el movimiento y los clips generados, mientras que Synthesia recibiría un guion fijo para crear un vídeo explicativo con un presentador de IA y una voz en off generada. La comparación utilizaría las herramientas creativas de Runway y Synthesia.
Las pruebas de audio deberían mantener el texto constante. ElevenLabs puede generar voz, crear voces y realizar doblajes, mientras que Suno puede convertir descripciones en canciones con voz o pistas instrumentales de géneros y estados de ánimo específicos. Examinaría las variaciones de narración mediante su plataforma de voz y los resultados de los arreglos de Suno.
Para el trabajo de software, utilizaría un proyecto existente en lugar de una muestra de código aislada. Cursor puede explicar el proyecto y proponer modificaciones en varios archivos a partir de la descripción en lenguaje natural de una función o un error, mientras que v0 puede generar un sitio web o una aplicación web inicial para previsualizarla y revisarla mediante el editor Cursor y v0 de Vercel.
La transcripción de reuniones puede compararse con una grabación para detectar omisiones, evaluar la precisión del resumen y comprobar si los elementos de acción son útiles sin tener que reproducir toda la sesión. Realizaría esa comparación con el asistente para reuniones de Otter.
El procedimiento final conectaría varias aplicaciones y enviaría información entrante controlada a través de pasos de resumen, categorización y enrutamiento. Confirmaría que el resultado llegue al destino correcto en cada ocasión utilizando Zapier, donde se puede crear una automatización.